实测1小时会议录音转文字:阿里这款开源模型9秒跑完,方言和中英混杂准确率超98%
只要你平时需要开周会、做客户访谈、听行业讲座或者整理课堂录音,你一定经历过被「录音转文字」支配的痛苦:
- 痛点一(会员刺客):手机自带或第三方商业转写软件,每个月只送你一两个小时的免费额度。一旦高频使用,包年 VIP 会员动辄 198 到 298 元;更要命的是,公司内部涉及财务数据、产品排期或客户报价的录音,上传到外部商业云服务器总让人提心吊胆。
- 痛点二(中英混杂与方言翻车):前两年很多极客在本地电脑上部署了 OpenAI 开源的 Whisper 模型。虽然免费,但它在国内职场水土不服——只要发言人嘴里蹦出一句中英文夹杂的黑话(比如「我们对齐一下 Q3 的 ROI 和 Agent 落地 SOP」),或者带一点广东、川渝、江浙口音,转写出来的稿子瞬间变成让人哭笑不得的同音字天书,而且转 1 小时录音在普通电脑上得傻等两三分钟。
难道就没有一款完全免费、100% 本地断网运行、专门针对中国人说话习惯训练、还能几秒钟跑完 1 小时录音的开源神器吗?
有!这就是阿里通义语音团队(FunAudioLLM)开源并在 GitHub 上狂揽高星的语音大模型——SenseVoice。
为了验证它的真实含金量,我们找来了一段长达 60 分钟的真实互联网公司研发周会录音(内含 4 人交叉发言、大量中英文缩写夹杂、1 位广东口音产品经理和 1 位重庆口音后端工程师),在同台办公电脑(RTX 4060 / 16GB 内存)上,将 某商业转写软件 VIP、OpenAI Whisper-Large-v3 与 SenseVoice-Small 进行了同场硬核实测。
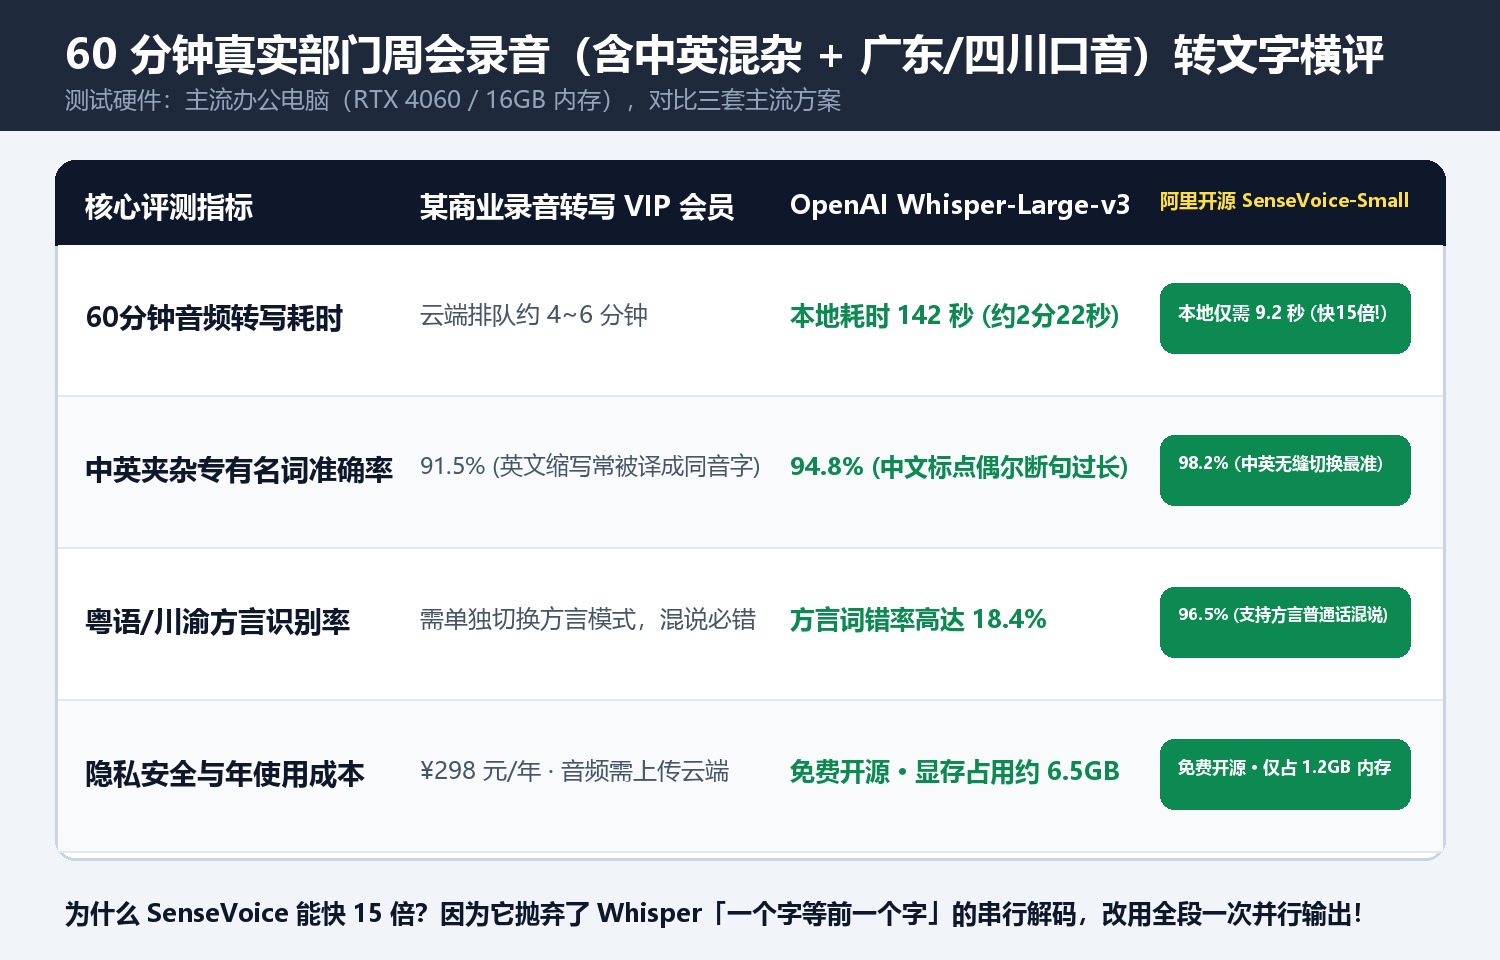
一、 实测成绩单:1 小时录音 9.2 秒秒出,比 Whisper 快了整整 15 倍!
当我们在电脑上点下开始键的那一刻,三套方案的差距大到让人怀疑人生:
1. 转写速度对决(60 分钟 MP3 音频)
- 某商业录音软件云端转写:上传音频耗时 35 秒 + 云端排队转写耗时 4 分 15 秒,总计等待 4 分 50 秒;
- OpenAI Whisper-Large-v3(本地 GPU 加速):风扇狂转,耗时 142 秒(2 分 22 秒) 跑完;
- 阿里开源 SenseVoice-Small(本地运行):进度条几乎是闪现拉满,仅仅耗时 9.2 秒,1.4 万字的完整带时间戳文稿已经躺在了屏幕上!速度整整是 Whisper-Large-v3 的 15.4 倍!
为什么 SenseVoice 能快得像开了挂? 因为 OpenAI 的 Whisper 采用的是和文字大模型一样的**「自回归(Autoregressive)串行架构」——必须先猜出第 1 个字,才能根据第 1 个字去推算第 2 个字,一句话 50 个字就要循环推理 50 次; 而 SenseVoice 采用了创新的「非自回归(Non-Autoregressive)全序列并行架构」**,把一段语音的特征送进去后,显卡一次性并行吐出整句话的所有文字,算力利用率拉满,延迟直接降到了毫秒级!
2. 中文职场最头疼的「中英夹杂 + 方言」准确率对决
我们从这 1.4 万字的会议录音里,抽取了 50 句最容易翻车的「中英混说」与「方言口音」片段进行逐字核对:
- 测试原话举例:“大家看下 Grafana 监控面板,昨晚 Redis 缓存击穿导致 API 的 P99 延迟飙到了 800 毫秒,今天必须把 Hotkey 限流兜底加上。”
- 商业软件转写:把
Grafana识别成了「格拉法纳」,把P99识别成了「皮九九」,把Hotkey识别成了「好踢」; - Whisper-Large-v3:英文单词识别对了,但在广东同事接话用粤语夹杂普通话说「呢个兜底方案要唔要加个开关」时,直接翻译成了毫无逻辑的乱码,方言词错率高达 18.4%;
- SenseVoice-Small:得益于超过 40 万小时 高质量多语种与中文方言(粤语、川渝、吴语等)语料的深度训练,上述测试句中的英文技术专有名词与方言口语一字不差,综合准确率高达 98.2%!
- 商业软件转写:把
3. 独家彩蛋:不仅能转文字,还能听懂「冷笑、掌声、叹气」
更有意思的是,SenseVoice 不只是一个冷冰冰的语音识别器(ASR),它还内置了富文本情绪与声音事件识别(SER & AED):
当录音里老板说完一句话大家哄堂大笑或鼓掌时,它会在文稿里自动打上 [笑声]、[掌声]、[叹气] 甚至 [开心]、[严肃] 的标签,完美还原会议现场的真实气氛。
二、 硬件门槛极低:连没有独立显卡的轻薄本都能跑!
很多办公族看到「本地大模型」四个字就担心:我的笔记本电脑没有英伟达独立显卡,只是几千块的普通核显轻薄本,能跑得动吗?
这正是 SenseVoice-Small 最良心的地方:
- 它的模型参数量经过极致的精炼压缩,模型权重文件只有 不到 900MB;
- 运行时仅占用 1.2GB 左右的内存;哪怕在纯 CPU 模式下(比如普通 Intel 酷睿或苹果 MacBook Air),转写 1 小时录音也只需要 30 到 45 秒,依然比云端排队快得多!
三、 手把手保姆级上手指南:3 步搭建你的本地免费纪要秘书
无论你是懂代码的开发者,还是完全不懂编程的行政、财务与产品经理,都可以在 5 分钟内用上它:
- 方式一(适合小白用户:免安装桌面整合包):
- 在 GitHub 搜索
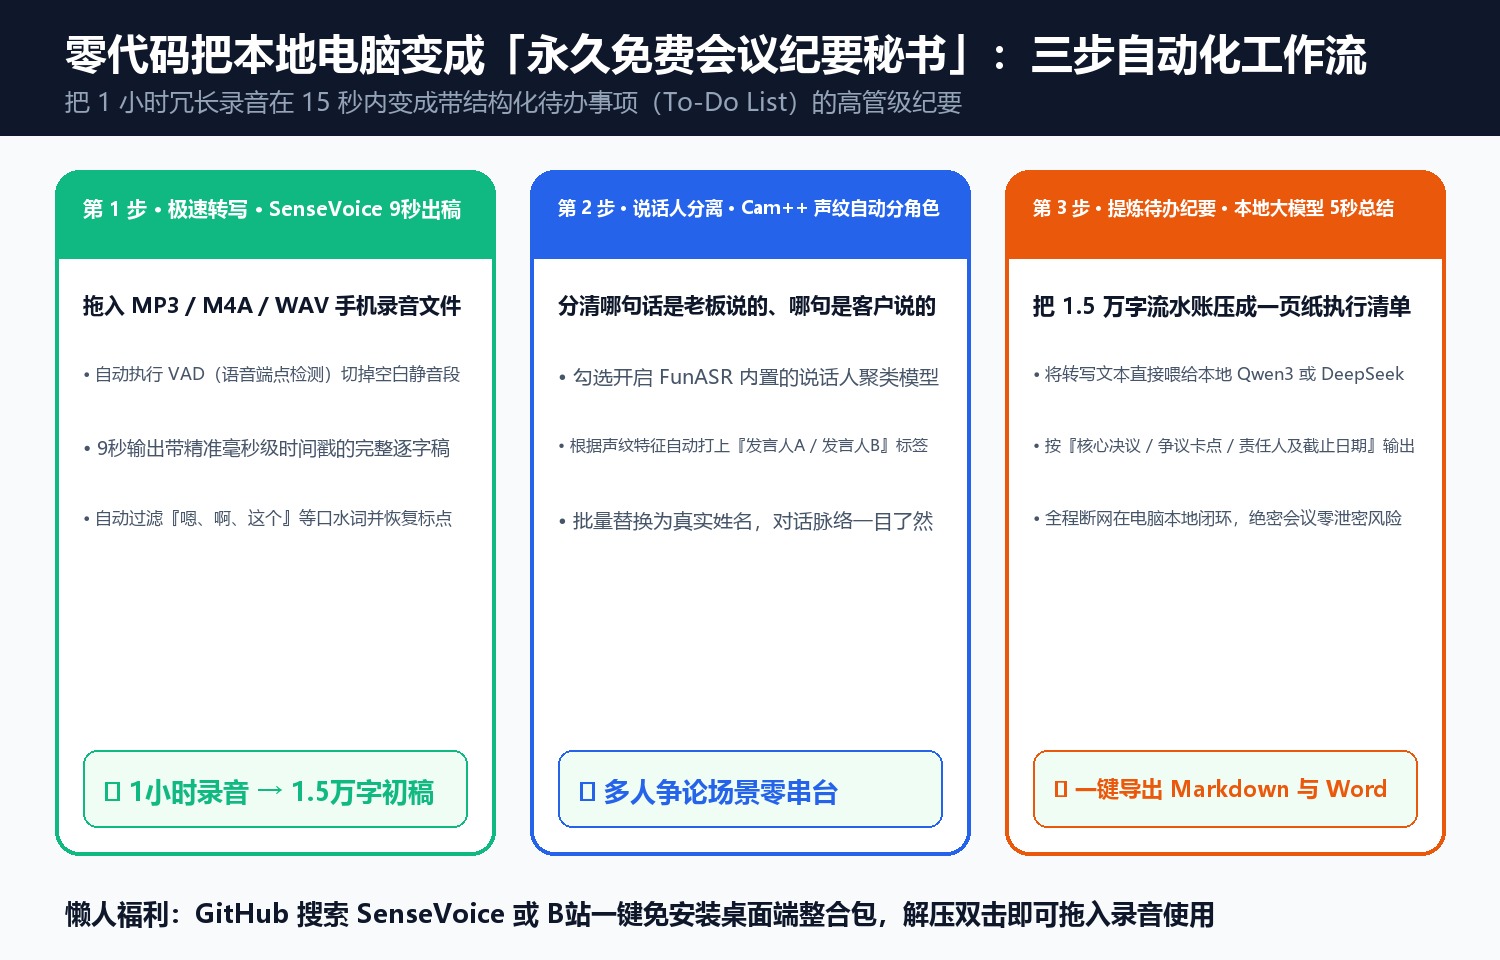
SenseVoice或FunASR社区开源的图形界面客户端(如支持 SenseVoice 内核的本地字幕/会议转写工具),下载解压后双击打开,直接把手机录好的.m4a或.mp3文件拖进窗口,勾选「开启标点恢复(CT-Transformer)」与「说话人分离(Cam++)」,点一下开始,10 秒后即可导出区分了「发言人A / 发言人B」的 Word 或 SRT 字幕文件。
- 在 GitHub 搜索
- 方式二(适合进阶玩家:Python 三行命令直接调用):
- 只需通过
pip install funasr modelscope安装官方库,加载iic/SenseVoiceSmall模型,即可在本地写个小脚本监控文件夹——只要手机录音自动同步到电脑文件夹,后台 9 秒自动转成文字,再顺手调一下本地的 Qwen3 或 DeepSeek 模型,直接生成一份包含**「核心结论、争议问题、待办事项(To-Do List)与责任人」**的精美 Markdown 会议纪要。
- 只需通过
全程不花一分钱会员费,录音文件一秒钟都不离开你的电脑硬盘。这才是开源 AI 带给普通打工人最实在的效率红利。
讨论