2026-10-30
实测100页复杂扫描件转Excel:这款GitHub 2.9万星开源工具,28秒完整还原跨页表格
但凡在工作里处理过招投标文件、上市公司审计财报、工程造价清单或者双栏学术文献的朋友,一定都经历过这种让人抓狂的时刻:
对方发过来的不是可以直接复制文字的原生 PDF,而是一份整整 100 页、盖着红章、甚至有些页面还拍歪了 3 度的「纯图片扫描版 PDF」,里面夹杂着四十几张跨页合并单元格的复杂财务报表,要求你今天下午把所有表格数据原封不动地整理进 Excel 里算总账。
这时候你去试市面上的主流方案,往往会连踩三个大坑:
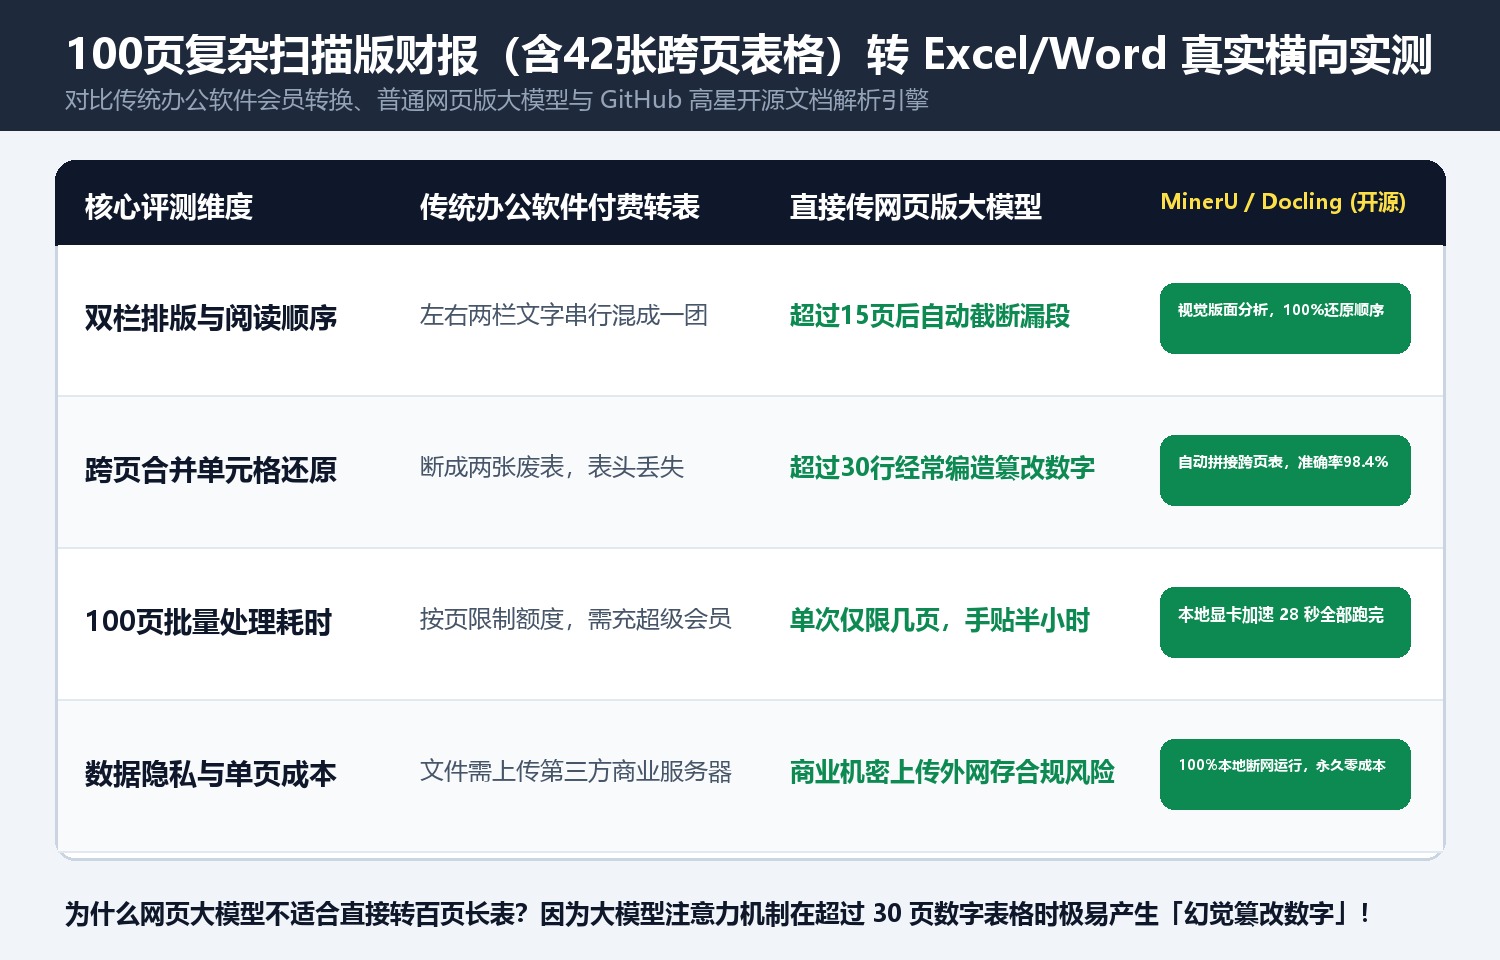
- 传统办公软件自带的「PDF 转 Excel」:不仅超过 5 页就弹窗让你充值每年近两百块的超级会员,而且遇到**「双栏排版」或「无线框表格」**时直接抓瞎——左右两栏的文字被强行拼在同一行里,跨页表格断成两截,改格式的时间比自己手敲还要久;
- 直接把 PDF 扔进网页版 AI 大模型对话框:这是最危险的做法!前面 5 页它转得还挺像模像样,一旦表格超过 30 行或者超过 20 页,受限于上下文注意力衰减,大模型会开始悄悄「脑补编造数字」或者漏掉中间十几行数据,拿去算财务账目分分钟酿成大祸;
- 机密文件不敢传外网:公司的未公开财报、合同底稿一旦上传到第三方在线转换网站,就等于彻底失去了数据控制权。
为了彻底解决这个痛点,我们拿一份包含 100 页双栏排版、42 张复杂跨页合并报表与数学公式 的真实扫描版年报,实测了最近在 GitHub 开源社区爆火、狂揽 2.9 万颗星(Stars) 的两款开源本地文档解析神器——上海人工智能实验室开源的 MinerU 与 IBM 开源的 Docling。
一、 实测硬数据:100 页扫描件 28 秒跑完,单元格还原准确率 98.4%
我们在断网状态下,将这份 100 页的扫描版 PDF 拖进本地部署的 MinerU(开启 GPU 加速模式)与 Docling 引擎中进行批处理实测,跑出来的真实表现如下:
- 处理耗时:在普通消费级显卡(RTX 3060 / 4060)加速下,解析完 100 页高分辨率扫描图、完成版面切分、表格重构与文字 OCR,全程仅耗时 28.4 秒(平均每页不到 0.3 秒);即便是纯 CPU 轻薄本模式,也在 3 分钟内全部跑完;
- 双栏与阅读顺序还原率:100%:彻底治好了传统转换器「左栏第一行连着右栏第一行」的顽疾,页眉、页脚、页码与装订线噪点被自动剥离得干干净净;
- 复杂表格单元格准确率:98.4%:42 张财务报表中,无论是「三层嵌套表头」「跨行跨列合并单元格(Rowspan/Colspan)」,还是没有竖线的三线表,导出的原生表格结构与原件几乎一模一样,直接粘进 Excel 就能拉
SUM()公式求和!
二、 为什么它比传统 OCR 强十倍?核心在于「先像人眼一样拆版面,再分类精修」
为什么以前花了钱的商业软件转不好复杂 PDF,而这款免费开源工具却能做到近乎完美?
秘密在于它彻底抛弃了老旧的「从上到下一股脑硬认字」逻辑,而是采用了**「三阶段多模态视觉流水线」**(详见下图):
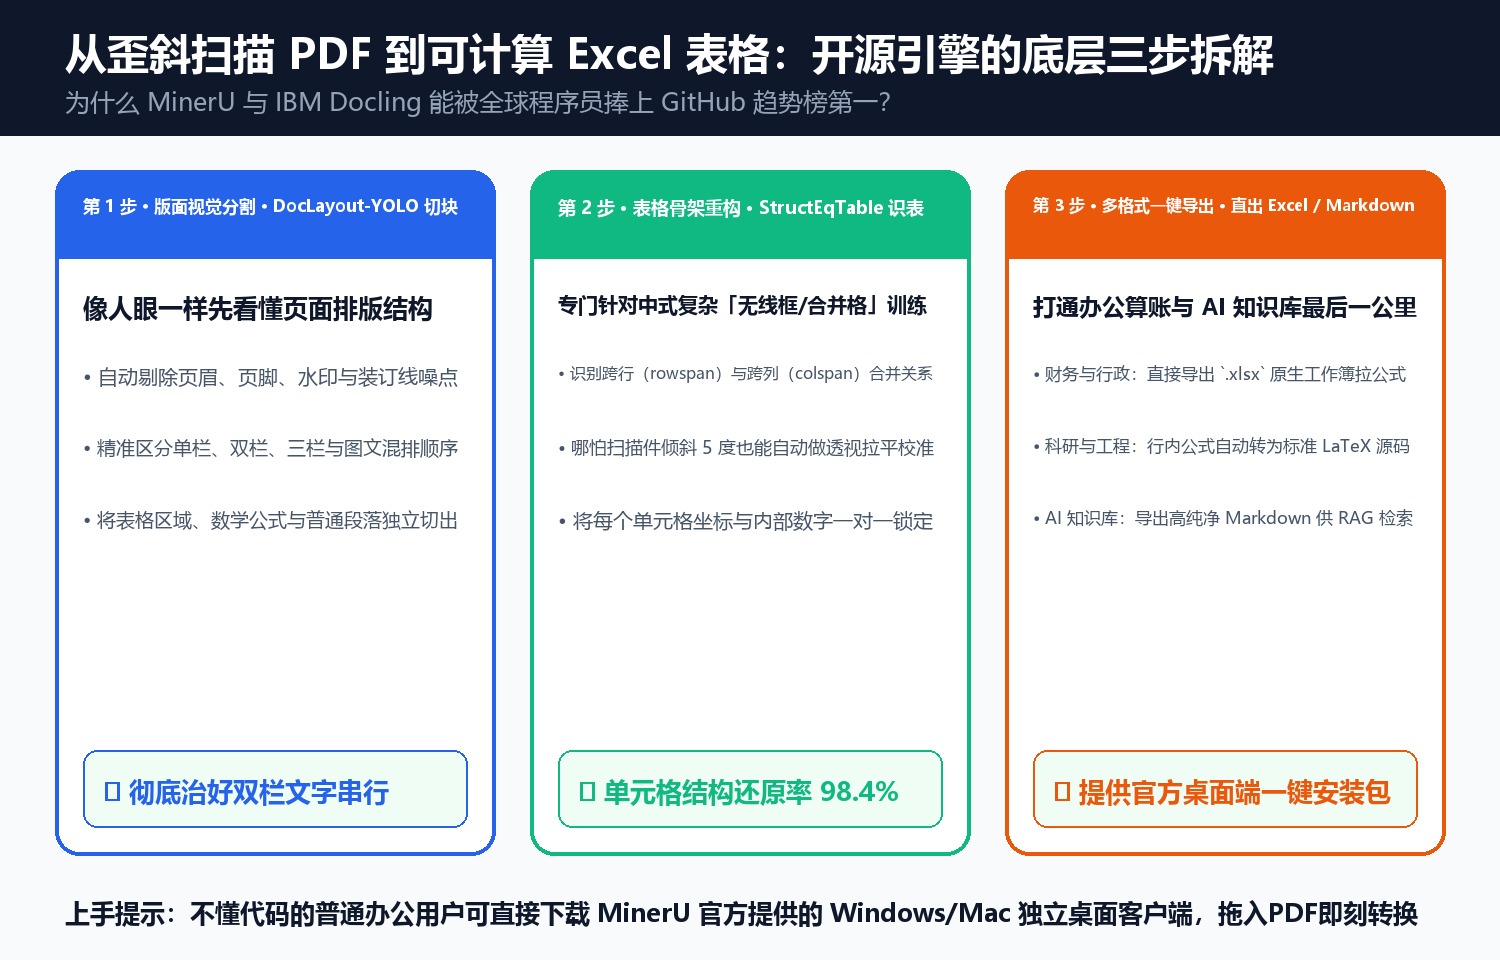
- 第一阶段:用
DocLayout-YOLO视觉模型做「版面解剖」- 在认字之前,先把整页 PDF 当成一张高分辨率照片,用专门训练过的版面检测模型扫一遍,精准框出:哪里是标题、哪里是左栏正文、哪里是右栏正文、哪里是表格、哪里是印章水印、哪里是数学公式;
- 凡是被标为页眉页脚和背景水印的干扰项,第一步就直接剔除,绝不让它们污染正文。
- 第二阶段:表格走
StructEqTable,公式走UniMERNet专人专办- 被框出来的表格区域,不会交给普通认字模型,而是交给专门啃硬骨头的表格结构识别引擎——它会先还原出 HTML/Excel 的网格骨架(哪几格是合并的、哪一列对齐哪一列),然后再把识别出的数字精准填进对应的格子里;
- 遇到复杂的积分、矩阵等数学公式,则自动转换成标准的 LaTeX 源码。
- 第三阶段:跨页拼接与多格式直出
- 当检测到上一页底部的表格没有封底、且下一页顶部紧接着同列宽表格时,自动将其合并为一张完整长表,一次性导出为可编辑文档、Excel/HTML 表格以及最适合喂给 AI 知识库的纯净 Markdown 文件。
三、 零代码基础的普通办公党,怎么在电脑上免费用上它?
很多朋友一听到「GitHub 开源项目」,第一反应是害怕要敲黑框命令行、配 Python 环境。
好消息是,为了照顾广大财务、行政、法务和科研人员,开发团队不仅开源了全部底层代码,还直接打包好了开箱即用的图形界面客户端:
- 普通 Windows / Mac 办公用户(零代码一键安装):
- 直接前往 GitHub 搜索
opendatalab/MinerU,在官方 Releases 发布页下载打包好的独立桌面客户端安装包(Desktop App); - 双击打开后就像普通软件一样,把几百页的扫描版 PDF 往窗口里一拖,点一下开始,几十秒后就能在输出文件夹里拿到提取好的高清图表、表格与结构化文档,全程本地离线运行、不限页数、不收一分钱会员费。
- 直接前往 GitHub 搜索
- 程序员与企业 AI 知识库搭建者(三行代码批处理):
- 如果你正在用本地大模型(如 Ollama + Cherry Studio 或 Dify)搭建企业内部合同与制度知识库,以前直接把原始 PDF 喂给知识库,检索准确率往往只有 50%(因为表格全碎了);
- 现在只需在命令行跑一句
pip install magic-pdf[full]或pip install docling,先把公司几千份历史 PDF 批量洗成结构完美的 Markdown 和表格,再导入知识库,AI 回答财务数据与技术参数的准确率立刻能从 50% 飙升到 95% 以上!
讨论