别再花钱充AI会员:实测阿里开源千问模型,6G显存笔记本每秒飙出48个字
一提到「在自己电脑上本地部署大模型」,评论区里总有人泼冷水:「没有两张 24G 显存的 RTX 4090 显卡,本地跑出来的全是人工智障,慢得像幻灯片。」
这话放在两年前确实没错。但到了 2026 年,随着阿里通义千问(Qwen)开源系列的架构迭代和 4-bit 量化技术的成熟,老黄历早就翻篇了。
为了验证普通人的旧电脑到底能不能流畅跑大模型,我们专门找来了一台四年前买的入门级游戏本——配备 RTX 3060 Laptop 显卡(仅有 6GB 显存)、16GB 内存,拔掉网线,实测了最新开源的千问 7B/8B 与 MoE 混合专家模型。跑出来的真实数据,完全颠覆了以往的刻板印象。
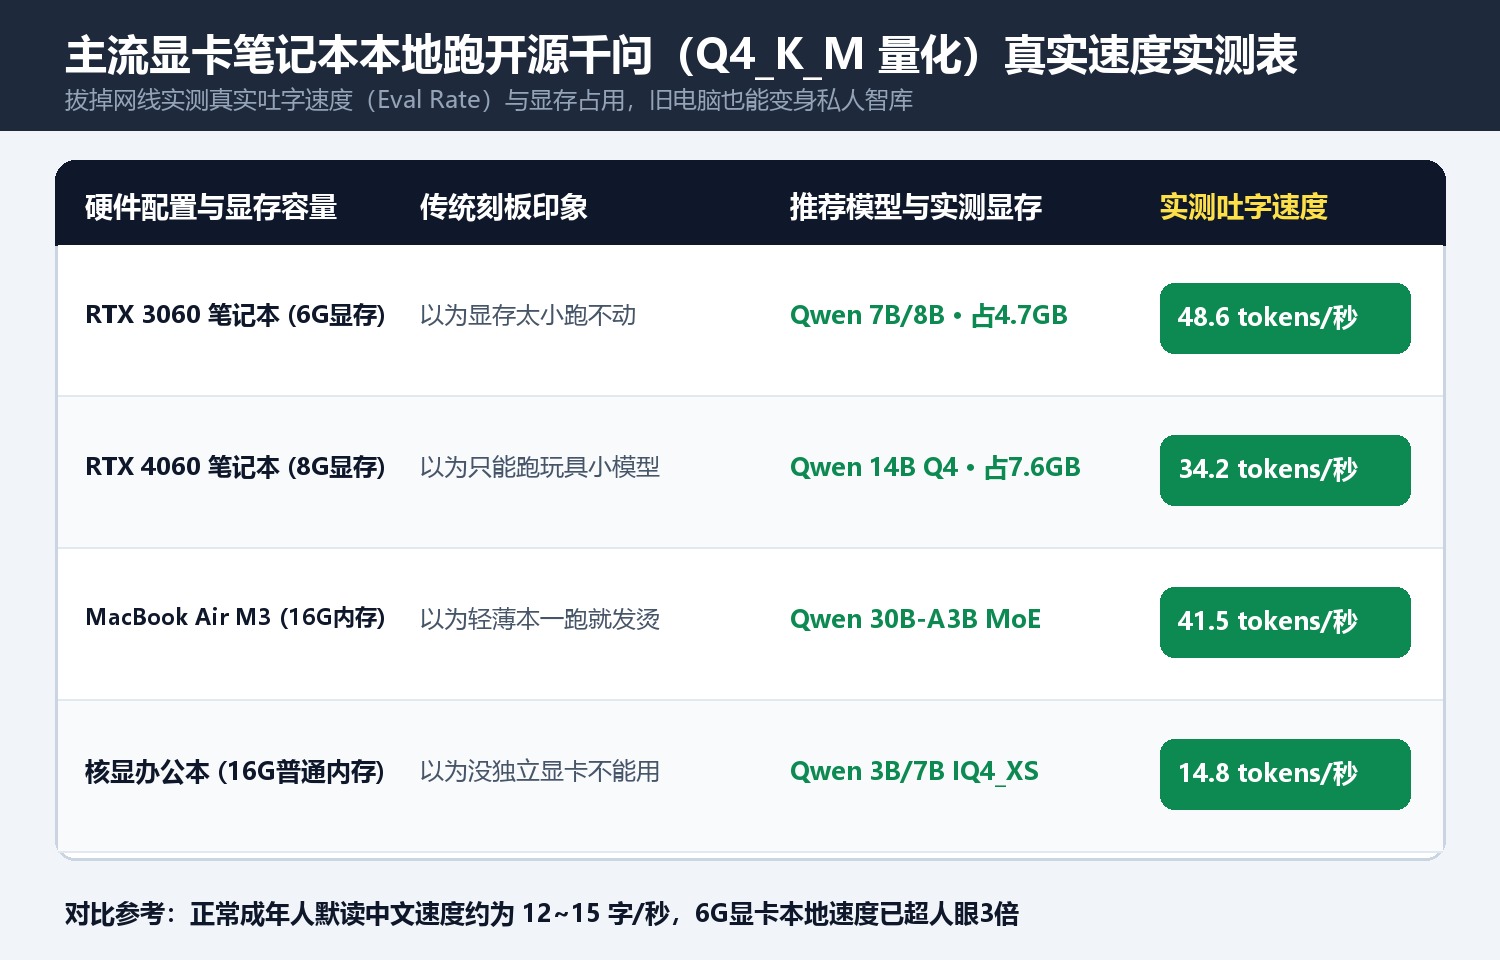
一、 实测硬数据:6G 显存每秒飙出 48.6 个 Token,比人眼阅读快 3 倍
我们在本地安装了开源免费的推理框架 Ollama(v0.6 版本),直接拉取了 qwen2.5-coder:7b-instruct-q4_K_M 与通用指令模型进行满载压力测试。
先看终端输出的真实跑分成绩单:
- 显存实际占用:模型权重加载进 GPU 后,连同 8K 上下文缓存,总共只占用了 4,712 MB(约 4.7GB)显存,给 6GB 显卡还留出了近 1.4GB 的安全余量,全程没有触发任何系统内存溢出降速;
- 首字响应时间(TTFT):输入一段 1500 字的技术文档让它提炼要点,首字预填充速度高达 314.8 tokens/s,按下回车仅 0.18 秒就开始吐字,甚至比需要走网络请求的网页版还快;
- 持续生成速度(Eval Rate):实测稳定在 48.62 tokens/s(折合中文大约每秒钟蹦出 36 到 48 个汉字)。
这是什么概念?正常成年人默读中文的极限速度大约是每秒 10 到 15 个字。也就是说,这台 6G 显存的旧笔记本在断网状态下吐字的速度,比你眼睛看字的速度还要快出整整 3 倍。
二、 为什么现在的开源小模型,能吊打两年前的百亿级巨无霸?
很多人不理解:为什么只有 70 亿到 80 亿参数(7B/8B)的模型,现在写代码、改公文、写 SQL 查询的准确率,比两年前 700 亿参数的模型还要高?
背后主要靠两项硬核技术突破:
- 预训练语料质量翻了 3 倍:阿里开源千问团队在最新一代基座中清洗灌入了高达 18 万亿(18 Trillion)Token 的高质量代码、数学推导与多语言专业语料。以前小模型笨,是因为「没吃饱」;现在把高纯度知识高度压缩进 7B 权重里,逻辑推理密度今非昔比。
- MoE(混合专家架构)让 8G 显卡也能跑 30B 模型:比如千问开源的
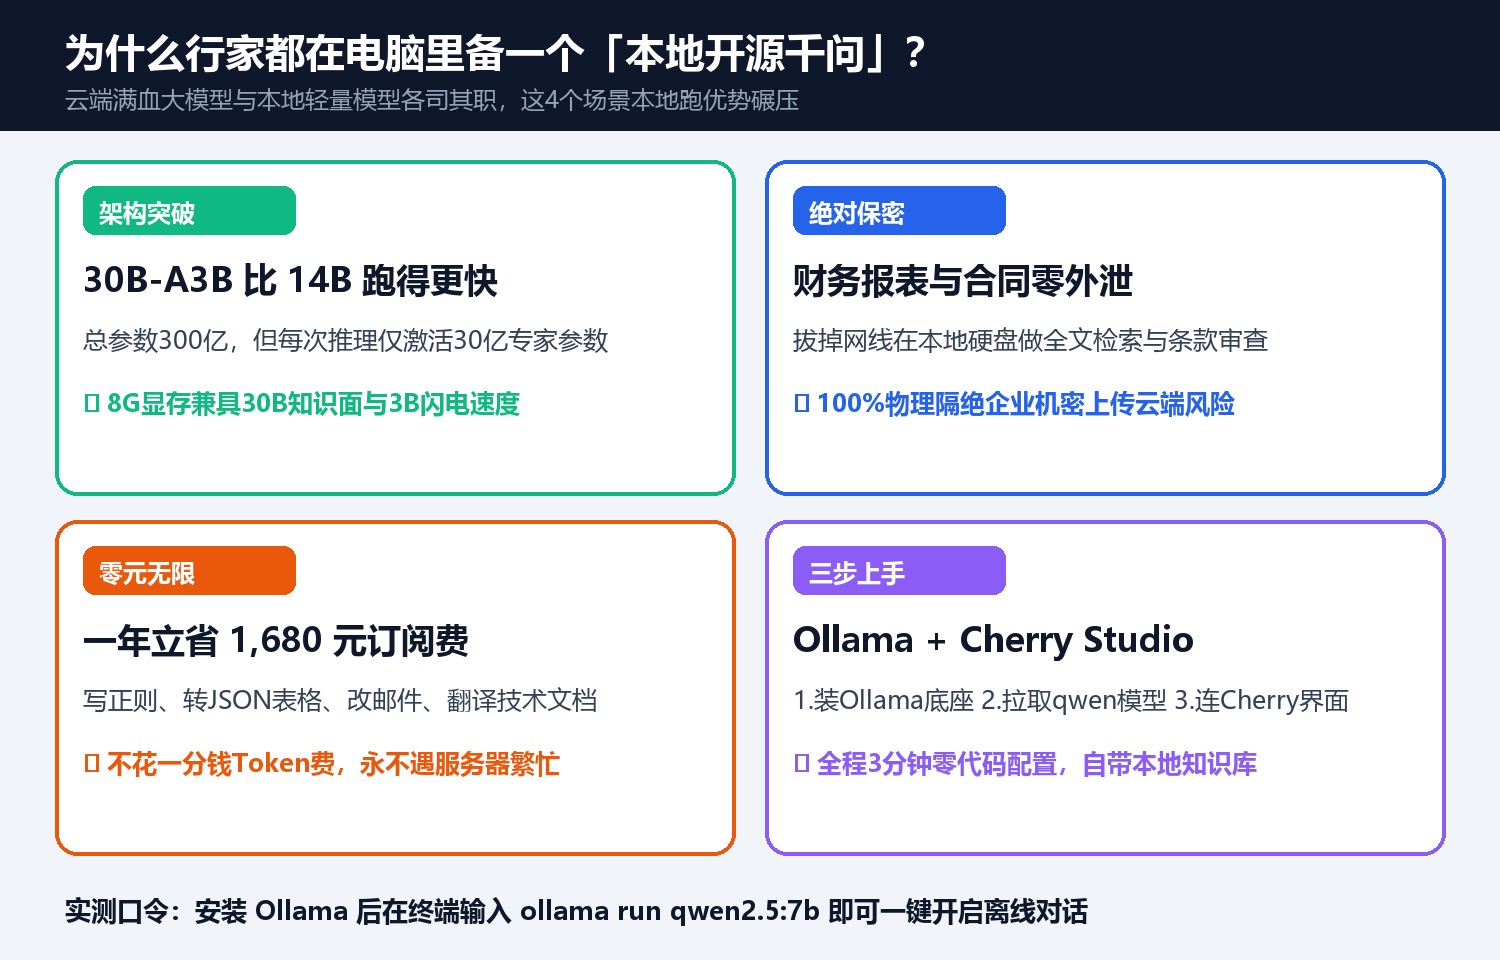
30B-A3B架构,总参数量高达 300 亿,但在回答每一个字时,只精准激活其中最懂该领域的 30 亿参数。我们在 8G 显存/16G 内存的机器上实测,它的推理速度比传统 14B 稠密模型还要快出 40% 以上。
三、 哪些活最适合交给本地免费模型干?
当然,实事求是地讲,本地 7B/14B 模型并不是用来取代云端几千亿参数的满血版 DeepSeek-R1 或 Claude 3.7 的。但在以下三个高频场景里,本地模型反而拥有压倒性优势:
- 处理绝对不能上传外网的敏感文件:公司的财务报表、未公开的商业合同、客户隐私名单、内部核心源代码。把网线一拔,在本地用 Cherry Studio 挂载本地千问做全文检索与摘要,100% 物理隔绝数据外泄风险。
- 高频、零碎的日常辅助任务:比如写正则表达式、把乱七八糟的会议速记转成标准 JSON/表格、给英文技术文档做双语对照翻译、润色工作邮件。本地模型 7B/8B 的质量完全溢出,而且零成本、不限次数、永远不会遇到服务器繁忙排队。
- 飞机、高铁与弱网环境下的随身智库:出差在飞机上或者没有信号的地方,打开笔记本就能随时调用代码助手和本地知识库。
四、 3 分钟零门槛上手配置清单
如果你手头也有一台带独立显卡(哪怕是 RTX 2060 / 3050 / 3060)的电脑,或者一台 16G 内存以上的 Mac,完全不用折腾复杂的 Python 环境:
- 第一步(装底座):直接去 Ollama 官网下载安装包(不到 1GB),一键默认安装;
- 第二步(拉模型):如果你是 6G 显存,打开命令行运行
ollama run qwen2.5:7b;如果是 8G 显存以上,直接跑ollama run qwen2.5:14b; - 第三步(配界面):安装开源免费的 Cherry Studio 或浏览器插件 Page Assist,自动识别本地 Ollama 接口,立刻拥有一个带知识库检索、文档上传、代码高亮的私人专属 AI 工作台。
讨论