TAG · 标签

# Ollama

← 全部标签 · 共 3 篇

2026-10-31

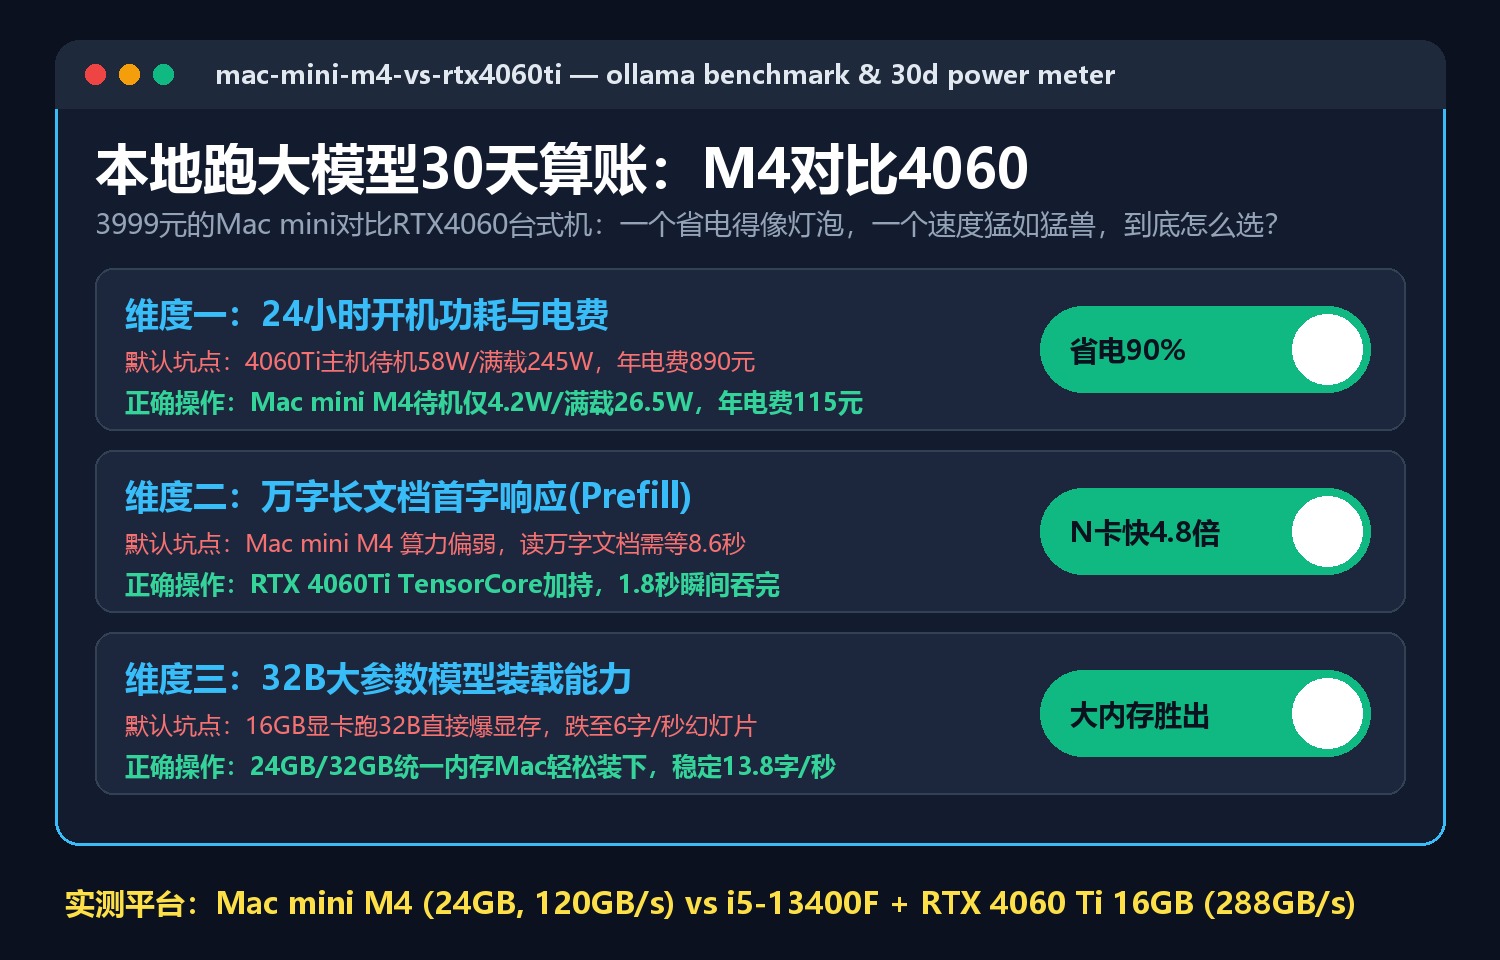
用Mac mini跑本地大模型一个月:对比RTX4060台式机,算完电费和吐字速度差距太大了

想在家里搭一台24小时在线的本地大模型与AI智能体服务器,到底该买3999元起的苹果Mac mini M4,还是组装一台带RTX 4060 Ti 16GB大显存显卡的Windows台式机?我们把这两台机器同时插上智能功耗插座,连续30天实测Ollama本地运行Qwen3-14B与DeepSeek-32B蒸馏模型。实测数据揭示了「苹果统一内存」与「英伟达CUDA高带宽」各自最致命的短板与优势。
用Mac mini跑本地大模型一个月:对比RTX4060台式机,算完电费和吐字速度差距太大了
2026-10-29

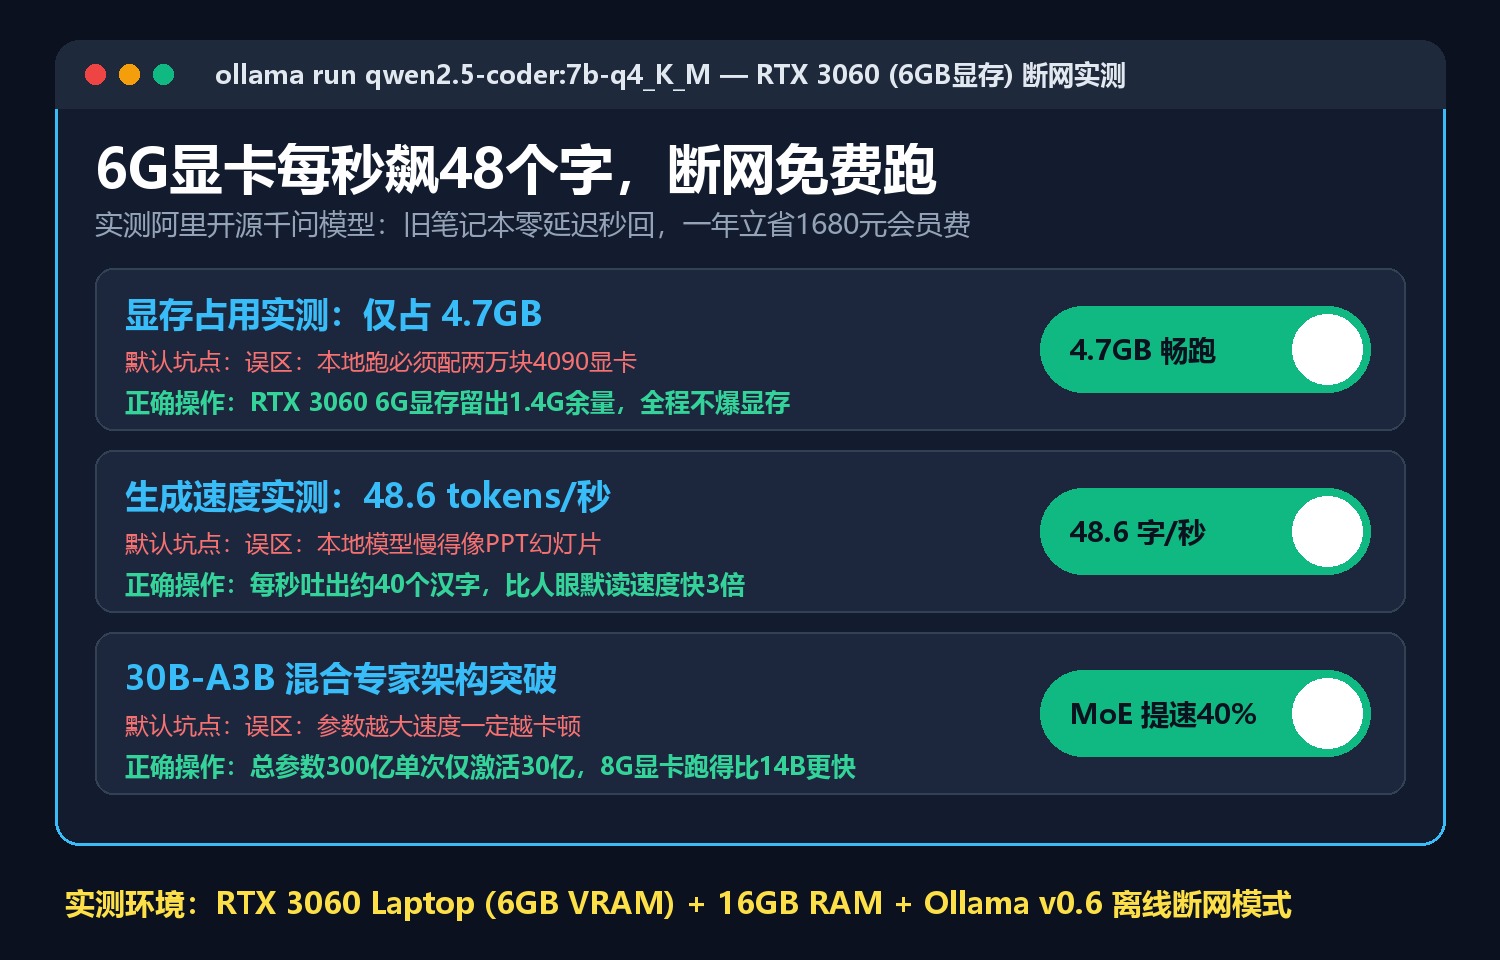
别再花钱充AI会员:实测阿里开源千问模型,6G显存笔记本每秒飙出48个字

很多人以为本地跑AI大模型必须配几万块的顶级显卡。我们拿一台四年前的RTX 3060(6GB显存)旧笔记本实测阿里最新开源千问模型:每秒生成48.6个Token,断网零延迟,一年立省1680元会员费。

别再花钱充AI会员:实测阿里开源千问模型,6G显存笔记本每秒飙出48个字
2026-09-03

Markdown笔记接本地AI不花钱(SoloMD教程03)

SoloMD 使用教程第 3 篇。上一篇的 AI 改写要填 key、按用量付钱。这篇讲另一条路:把模型下到自己电脑上跑,一分钱不花,断网也能用,笔记内容不出本机。含模型选型、内存对照表和三步配置。

Markdown笔记接本地AI不花钱(SoloMD教程03)