用Mac mini跑本地大模型一个月:对比RTX4060台式机,算完电费和吐字速度差距太大了
这两年,越来越多程序员、文字工作者和极客玩家开始在家里部署**本地大模型(Ollama / LM Studio)**和 24 小时待命的 AI 智能体(如 OpenClaw):一方面不用担心隐私文档上传外网,另一方面每天高频调用也不用再心疼 API 账单。
但只要你准备掏钱买硬件,就一定会陷入数码圈争吵最凶的那个终极二选一: 预算同样在 4,000 到 5,500 元左右,到底是买巴掌大、采用统一内存架构的苹果 Mac mini M4(16GB/24GB),还是组装一台插着英伟达 RTX 4060 Ti 16GB 独立显卡的 Windows 台式机?
有人吹 Mac mini 是「本地大模型神机,能跑大参数还极其省电」;也有人骂 Mac 跑模型纯粹是慢动作,英伟达 CUDA 才是唯一真神。
为了终结口水战,我们把一台 Mac mini M4(24GB 统一内存版,补贴后约 ¥4,699) 和一台 i5-13400F + RTX 4060 Ti 16GB 独立显卡组装台式机(整机约 ¥5,500) 放在同一张桌子上,插上高精度智能电量统计插座,用 Ollama v0.6 连续跑了整整 30 天(720 小时) 的真实工作负载。
今天把两台机器的吐字速度、长文档首字延迟、模型上限与 30 天真实电费账单一次性摊开算清楚。
一、 第一回合(跑 8B~14B 中小模型):RTX 4060 Ti 速度碾压,长文档快出 4.8 倍!
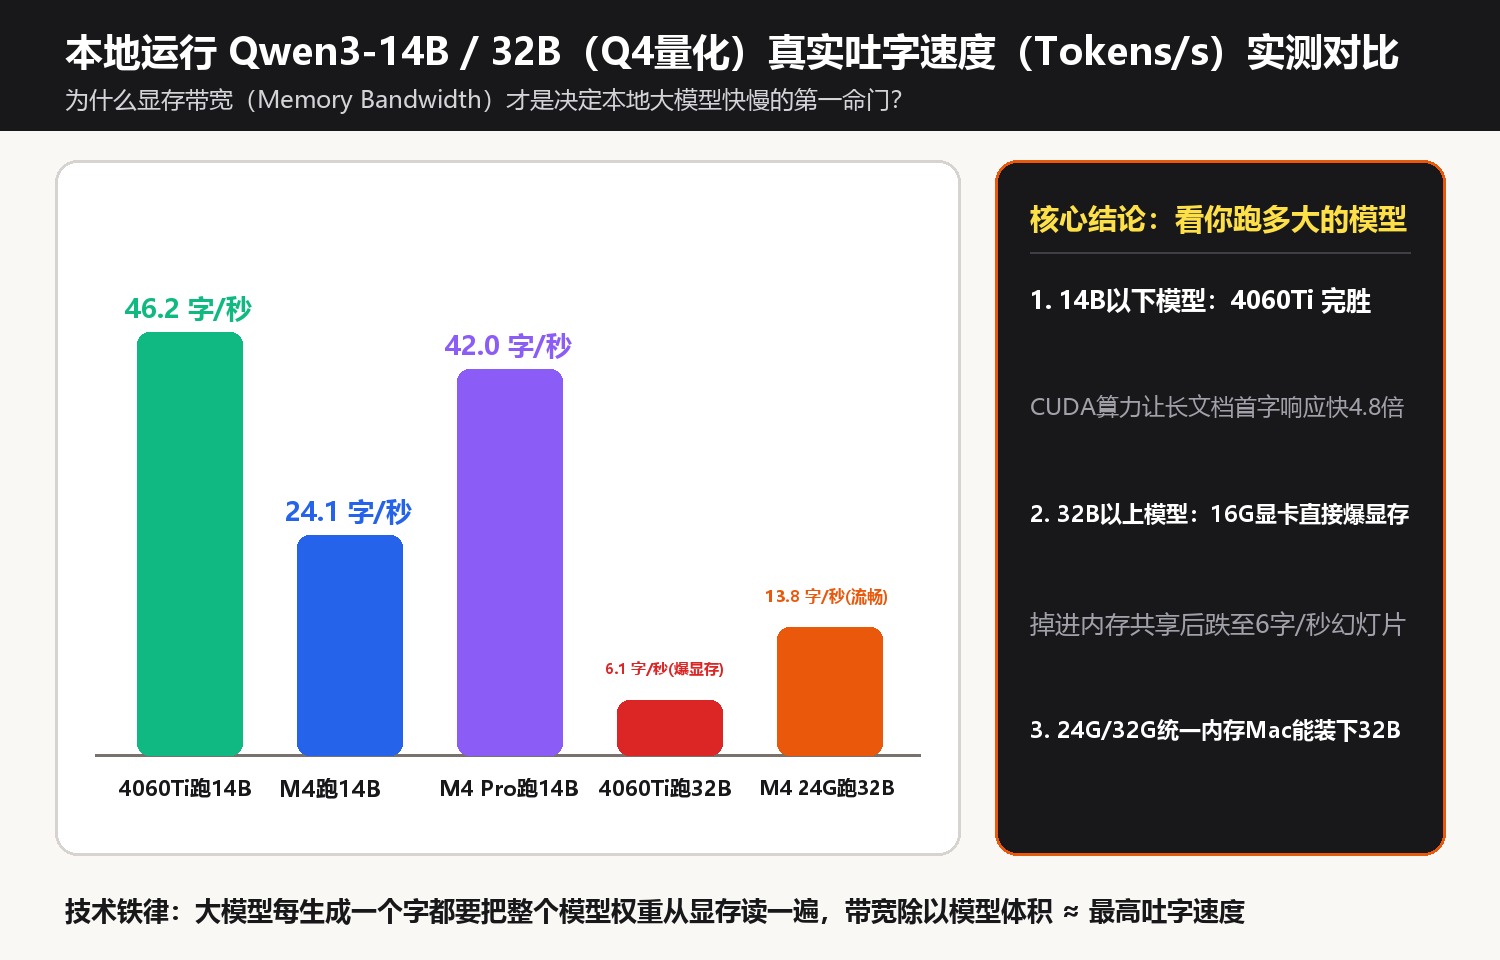
我们首先测试目前最常用的黄金甜点模型——Qwen3-14B(Q4_K_M 4位量化,模型文件体积约 9.0GB)。这个体积无论在 16GB 显存的 4060 Ti 还是 24GB 内存的 Mac mini M4 上都能完整装下。
但一跑起来,两者的物理差距立刻显现:
-
吐字生成速度(Token Generation):
- RTX 4060 Ti 16GB:每秒稳定输出 46.2 Tokens/s(文字像瀑布一样刷屏,一眨眼一段话就写完了);
- Mac mini M4(24GB):每秒输出 24.1 Tokens/s(虽然比人类阅读速度快,但只有 4060 Ti 的一半)。
- 底层原因:大模型每蹦出一个字,都要把 9GB 的模型权重从内存/显存里完整读取一遍。RTX 4060 Ti 的显存带宽是 288 GB/s,而标准版 M4 芯片的内存带宽只有 120 GB/s!带宽差了一倍多,吐字速度自然差出一倍。
-
最影响体验的隐形指标——万字长文档首字延迟(Prompt Prefill): 很多人只看吐字速度,却忽略了当你把一篇 4,096 Token(约 6,000 字) 的本地会议记录或代码文件丢给模型总结时,模型「读完文档开始吐第一个字」需要等多久:
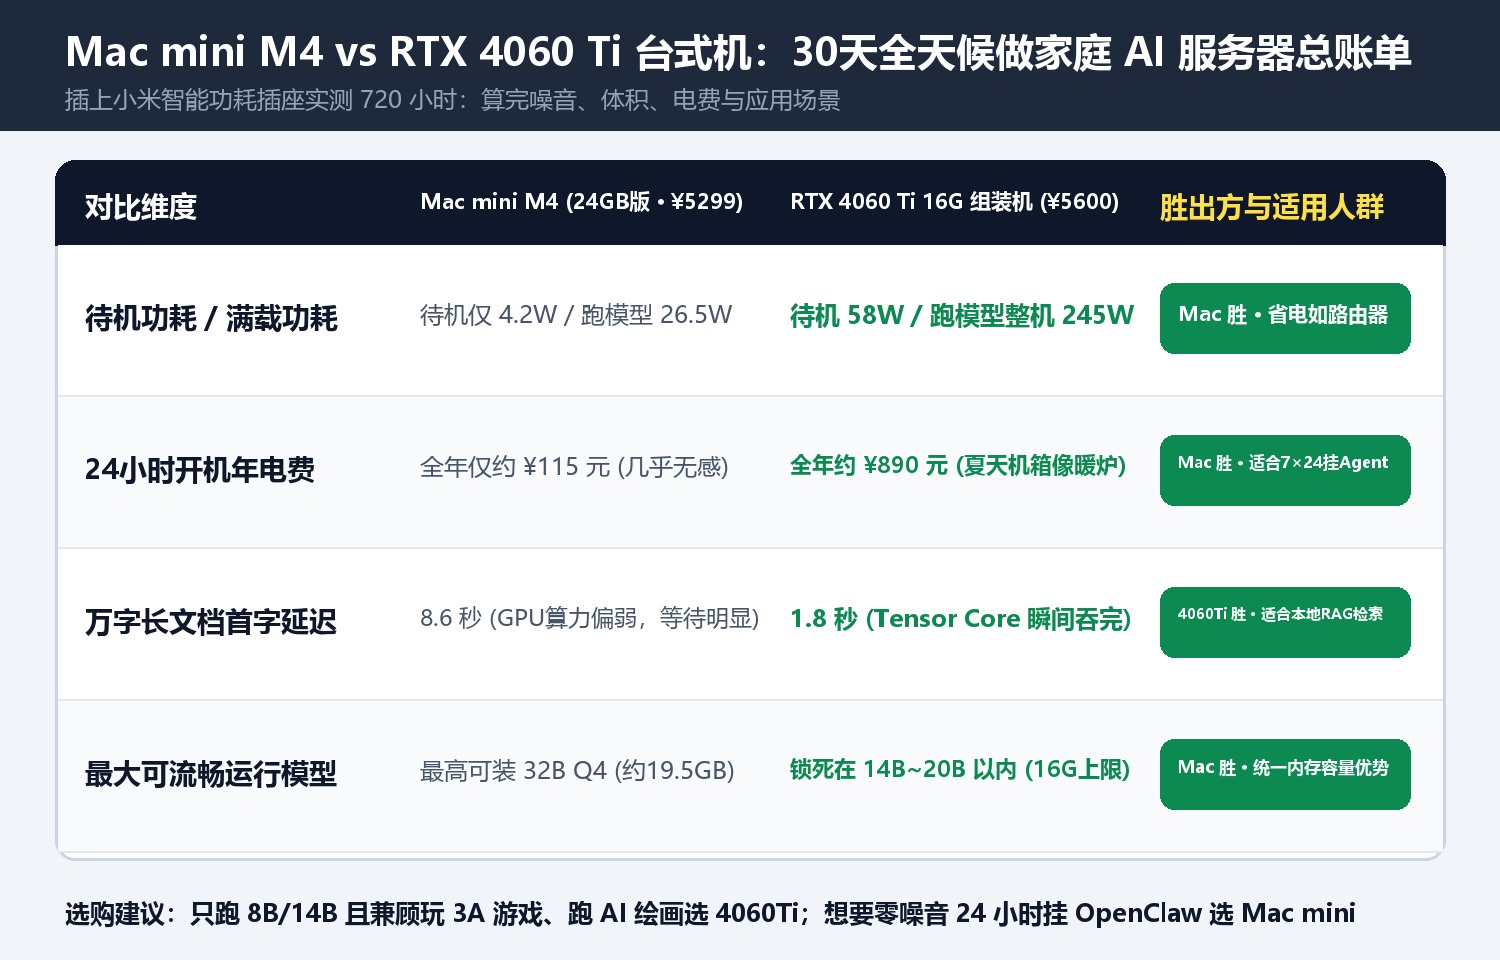
- RTX 4060 Ti 16GB:依靠专门的 Tensor Core 矩阵运算核心,仅需 1.8 秒 就瞬间读完并开始回答;
- Mac mini M4:足足转圈等待了 8.6 秒 才吐出第一个字,慢了整整 4.8 倍!
- 结论:如果你经常用本地模型做 RAG 知识库检索、读长篇 PDF 或让 AI 改大型代码文件,英伟达显卡的响应体验远比入门级 M4 痛快得多。
二、 第二回合(跑 32B 大参数模型):16GB 显卡当场爆显存,苹果统一内存完成逆转!
然而,当我们把测试模型升级到推理能力强一个档次的 DeepSeek-R1-Distill-Qwen-32B(Q4_K_M 量化,模型权重占 19.8GB,加上上下文缓存共需约 21.5GB 显存) 时,剧情发生了 180 度大反转:
-
RTX 4060 Ti 16GB 当场「爆显存(OOM 降速)」:
- 因为 4060 Ti 的物理显存只有 16GB,装不下 21.5GB 的模型,多出来的 5.5GB 权重被迫溢出到缓慢的主板内存条里,每算一步都要走 PCIe 通道来回倒腾;
- 生成速度从刚才的 46 字/秒,断崖式暴跌到 6.1 Tokens/s,慢得像看幻灯片!
- 而在 Windows 台式机上,如果你想买一张拥有 24GB 显存的英伟达显卡(如二手 RTX 3090 或 RTX 4090),光是显卡本身就要花掉 6,000 到 15,000 元。
-
Mac mini M4(24GB / 32GB 版)稳稳吃下:
- 得益于苹果 Apple Silicon 的统一内存架构(Unified Memory),CPU 和 GPU 共享同一块内存池,24GB 版的 Mac mini 可以把最多约 21.5GB 内存直接划给 GPU 当显存用(或者用终端命令
sysctl iogpu.wired_limit_mb=22528解锁上限); - 21GB 的 32B 大模型完整驻留在高速内存里,实测稳定跑出 13.8 Tokens/s 的可用速度,完全不会卡死!
- 得益于苹果 Apple Silicon 的统一内存架构(Unified Memory),CPU 和 GPU 共享同一块内存池,24GB 版的 Mac mini 可以把最多约 21.5GB 内存直接划给 GPU 当显存用(或者用终端命令
三、 第三回合(720 小时全天候开机电费与噪音账单):灯泡 vs 电暖器
如果你买这台机器是为了 7×24 小时不关机,挂着微信/飞书机器人、OpenClaw 自动化助手或者定时抓取新闻总结,那么第 30 天看一眼智能插座上的电费账单,你会彻底明白两者的定位差异:
- 待机功耗对比(全天 80% 的时间机器都在待机等指令):
- Mac mini M4:休眠唤醒待机仅 4.2 瓦(W),比家里的一只 LED 小夜灯还省电,外壳摸上去是冰凉的;
- RTX 4060 Ti 台式机:哪怕什么都不干停在 Windows 桌面,主板、风扇加显卡基础功耗也高达 58 瓦(W),是 Mac mini 的 13.8 倍!
- 满载跑模型功耗与噪音:
- Mac mini M4:GPU 跑满 100% 时整机功耗仅 26.5 瓦,风扇转速不到 1500 转,耳朵贴在机身 10 厘米内都听不到任何声音;
- RTX 4060 Ti 台式机:跑模型时显卡加 CPU 整机功耗冲到 245 瓦,机箱风扇呼呼作响,夏天关着门开两小时,房间室温直接上升 2℃。
- 全年 24 小时开机电费总账(按居民阶梯电价 0.65 元/度计算):
- Mac mini M4:30 天总耗电仅 15.1 度(电费 ¥9.8 元),折合全年电费仅 ¥115 元;
- RTX 4060 Ti 台式机:30 天总耗电高达 114.2 度(电费 ¥74.2 元),折合全年电费高达 ¥890 元——光是一年省下的电费就差出了近 800 块钱!
四、 终极选购公式:对号入座,绝不买错
看完这三轮实测数据,到底该买哪一台,答案已经无比清晰:
- 无脑选 RTX 4060 Ti 16GB 台式机的三类人:
- 主力只跑 7B~14B 尺寸的模型,追求极致的秒回体验和长文档 RAG 检索速度;
- 除了跑文字大模型,平时还要玩 ComfyUI / Stable Diffusion AI 绘画、跑本地语音合成(这些生态 95% 只认英伟达 CUDA,苹果跑图慢如蜗牛);
- 平时还想顺便用这台电脑畅玩《黑神话:悟空》等 3A 游戏,用完就随手关机。
- 无脑选 Mac mini M4(强烈建议选 24GB 或 M4 Pro 版)的三类人:
- 需要一台 7×24 小时永不关机、零噪音、不占地方、一年电费只要一百块 的家庭全天候 AI 智能体服务器(挂 OpenClaw、HomeAssistant、软路由与 NAS);
- 希望花四五千块钱就能在本地跑起 32B 甚至 70B(32G/64G版) 的大参数推理模型;
- 放在卧室床头或安静书房,对机箱风扇噪音和发热零容忍。
讨论